最大的成本,叫纪律
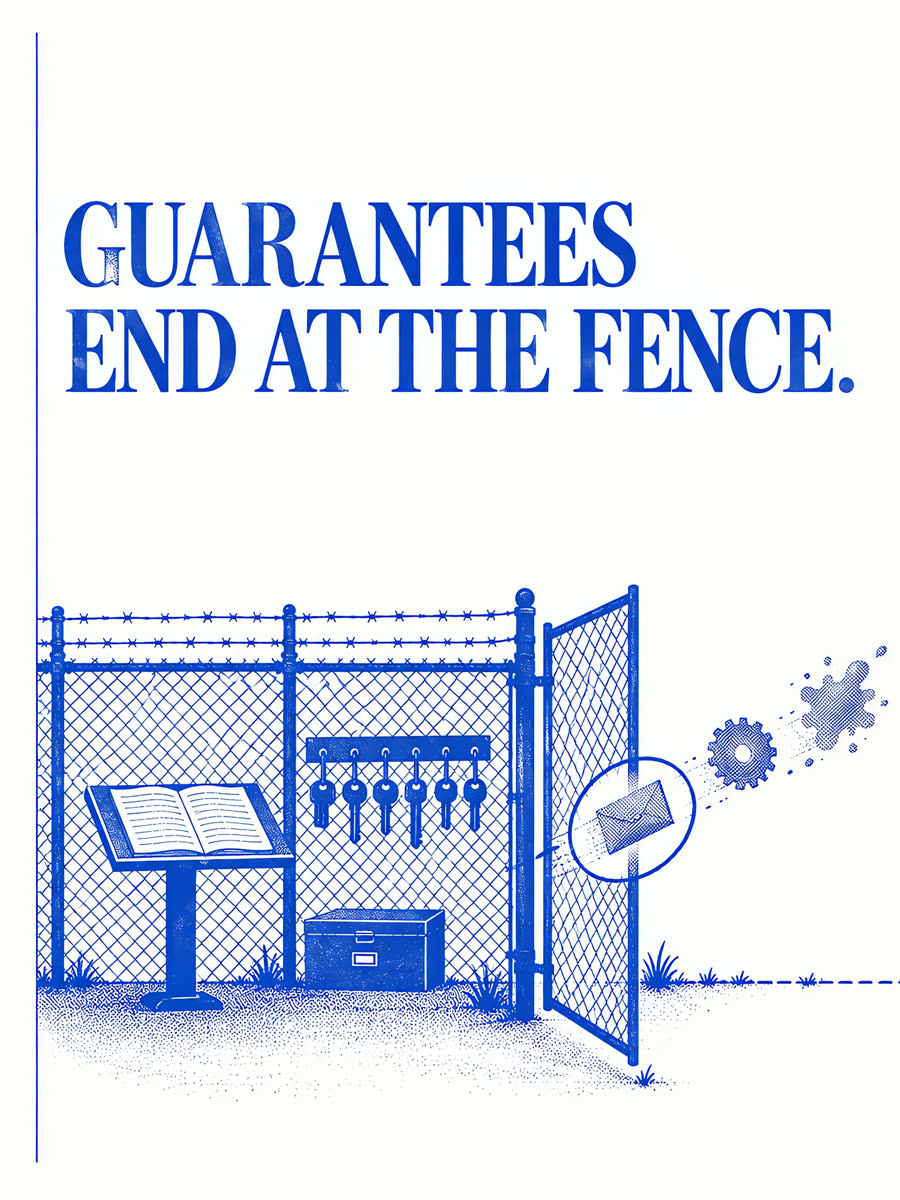
这套思想的所有保证,都建在一个前提上:一切共享状态登记进语境,一切交互走同一扇门。
这意味着采用它不是加一个库,而是一次改造:你的共享状态要一件件搬进门里。最危险的是只搬一半。一半进门、一半留在外面,你会以为整个系统都在保护之下,而真正没人管的,恰好是留在外面的那一半。
六条边界
撤销对不对,靠作者。 框架保证回执到点一定执行,但回执本身写错了,框架发现不了 p.59。它防得了「忘了写」,防不了「写错了」。
组件自己的内存不保留。 卸载就是撕回执,热重载就是拆旧装新。组件内存里攒的东西想留住,得放进一个比它活得更久的依赖里。
发出去的,收不回。 系统能独占、能还原的地方叫界内,界线就是系统边界;写到磁盘的文件、发出去的网络包在界外,那里的操作不记账,也不撤销 p.70。出了界只剩两条路:扣住先不发,或者事后补偿,比如删掉文件、退还扣款 p.71。
名字对上了,人可能不对。 依赖只按名字连接。组件各自开发、各自发版时,提供方改了接口,使用方还按老样子用,名字照样对得上,跑起来才出错 p.75。论文承认这还没有统一的解法。
循环依赖查得出,拆着疼。 两个组件互相需要,结果是两个都永远待命;好在光看依赖声明就能发现,加载时就能报出来 p.73。拆开的办法是把它们切细,再写专门的「胶水」组件分别连两边。正确性和速度不受影响,疼的是写配置、读系统的人。
证据是观察性的。 只有一个生态、一种语言,没有对照实验,开销没有量化 p.70。dsh 还在 developer preview,接口随时会变。
先问,再用
不可信的代码是另一个常见误区。依赖声明能管住组件「能拿到什么」,可恶意代码可以绕过语言层面的检查,直接碰底层对象 p.73。
要跑别人写的、你信不过的代码,仍然需要一个真正的沙箱。
哪些场景适合,哪些不适合
| 场景 | 判断 |
|---|---|
| 一次性脚本、组件常年不动的小工具 | 不适合:没有要撤的东西,纯开销 |
| 性能极度敏感、高频读写共享状态的热路径 | 慎用:额外开销还没有数字 |
| 要运行不可信的代码 | 不够:仍需独立沙箱 |
| 插件生态,作者互不认识 | 适合:Koishi 就是这个场景 |
| 会频繁给自己换零件的 agent | 很适合:论文点名的下一个验证场 p.83 |
五个问题
- 01你的组件需要在运行中装上、卸下、替换吗?
组件常年不动,就没有要撤的东西。这套机制在你这里是纯开销。
- 02共享状态能全部登记进一个统一入口吗?
有一条绕行(全局单例、模块级缓存),保证就漏一块。一半进门一半不进,比完全不用更危险:你会以为自己受保护。
- 03热路径上的操作,能承受一层登记和代理吗?
intercept、isolate 都有成本,论文没量化。拿到你自己的实测数字之前,别把「应该不大」当结论。
- 04要跑的代码都是你信得过的吗?
依赖声明能管住「能拿到什么」,管不住恶意代码绕过它。不可信的代码需要独立的沙箱,这套范式替代不了。
- 05团队能长期守住「所有交互都走同一扇门」吗?
纪律一松,保证就只停在纸面上。这一条最难,也最要紧。
全书到这里
回头看,这本书只讲了一件事:一个系统一边跑一边换零件,怎样才能不散架。论文的回答是三句口诀,你现在应该能背出来了:每个改动当场交出撤销办法;每个组件进门先交需求清单;所有事情都走同一扇门。
剩下的,交给你的项目。