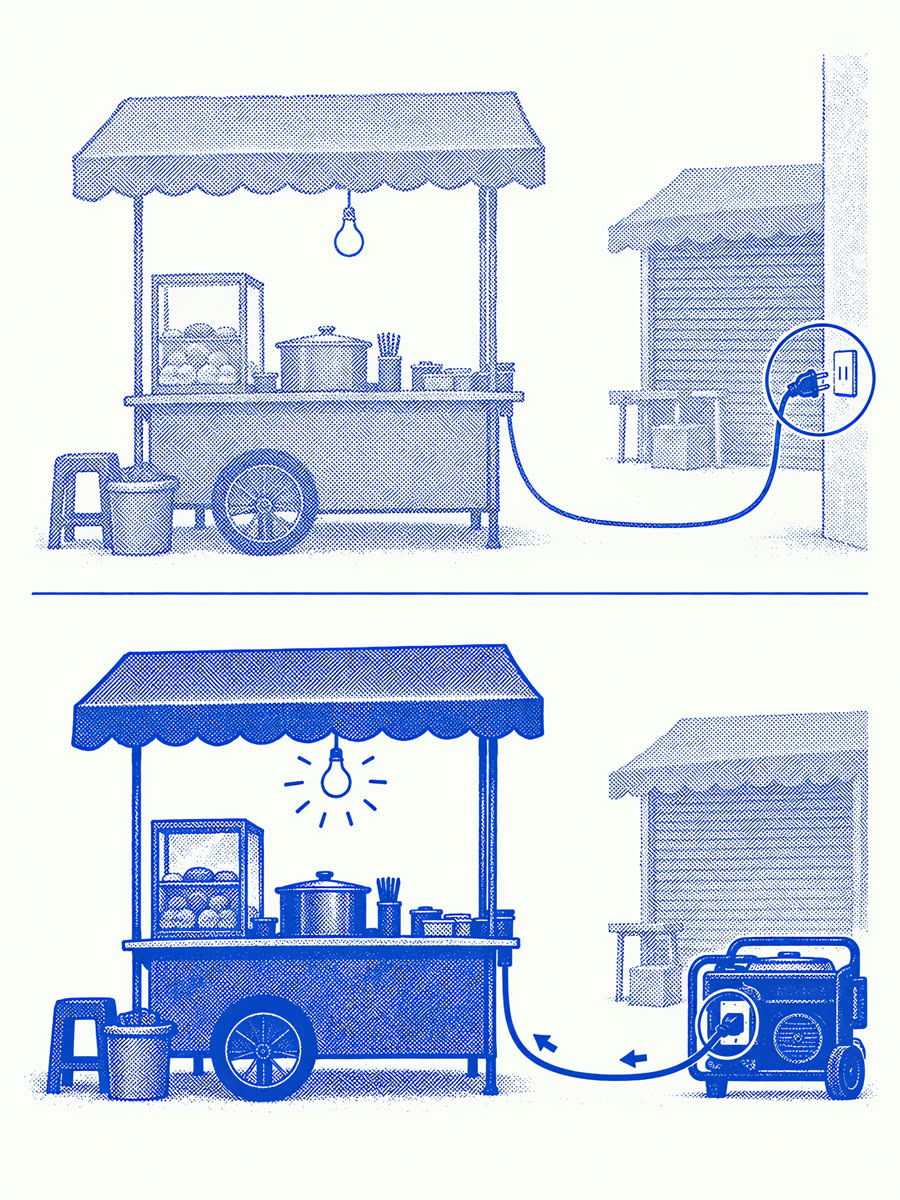
半夜那十几秒
小周的第二个坑:数据库抽风十几秒,提醒插件拿不到连接,崩了;管理插件跟着崩。
老写法的问题在于,依赖是「启动那一刻接好就不管了」。程序启动时把线连上,然后默认它永远在。线一断,所有用到它的地方同时出错。要防住,只能在每个插件里写一堆「先看看在不在、不在就重试」的代码。每个作者写一遍,写法还各不一样。
进门先交一张需求清单
论文的第二个思想叫响应式反效应。拆开说:组件进门时先交一张清单(Cordis 里叫依赖声明),写明「我需要什么」;运行时替它盯着环境。
环境每变一次(有东西上线、下线、换了),运行时就拿每一份清单对照这次变化,分成三类 p.6:
| 这次变化对它来说 | 运行时怎么做 |
|---|---|
| 从缺到齐 | 激活:让它上岗 |
| 从齐到缺 | 停用:让它歇着,并按回执撕干净 |
| 和它无关 | 不理,它甚至不会察觉 |
function sendReminder() {if (!db || !db.connected) { retryLater() // 每个插件都写一遍 return} db.query(...)}export const inject = ['database'] export function apply(ctx) { // 能走到这里,数据库一定在 ctx.on('message', () => { ctx.database.query(...) })}两个思想,严丝合缝
这里有个很漂亮的地方。「数据库上线」这件事本身,就是提供者做的一个改动:在环境里登记「我能提供数据库」。按上一章的规矩,这个登记也有回执。
所以数据库下线,就是撕掉这张登记的回执;撕的那一刻,所有清单上写着「数据库」的组件都会收到通知。第一个思想管「改动怎么撤」,第二个思想管「撤了以后谁受影响」,两者共用同一套账,不会出现「数据库已经走了,却没人通知插件」的空档。
还有顺序。数据库要走时,会先挂出停工告示,等依赖它的组件一个个撤完,自己才离场。谁先走、谁后走,由依赖关系决定,不由谁写在前面决定。这套流程的细节在第 07 章。
认人,不认货
演示的第三拍可能让你意外:换成备用库,连接地址一模一样,为什么提醒插件还要重新上岗?
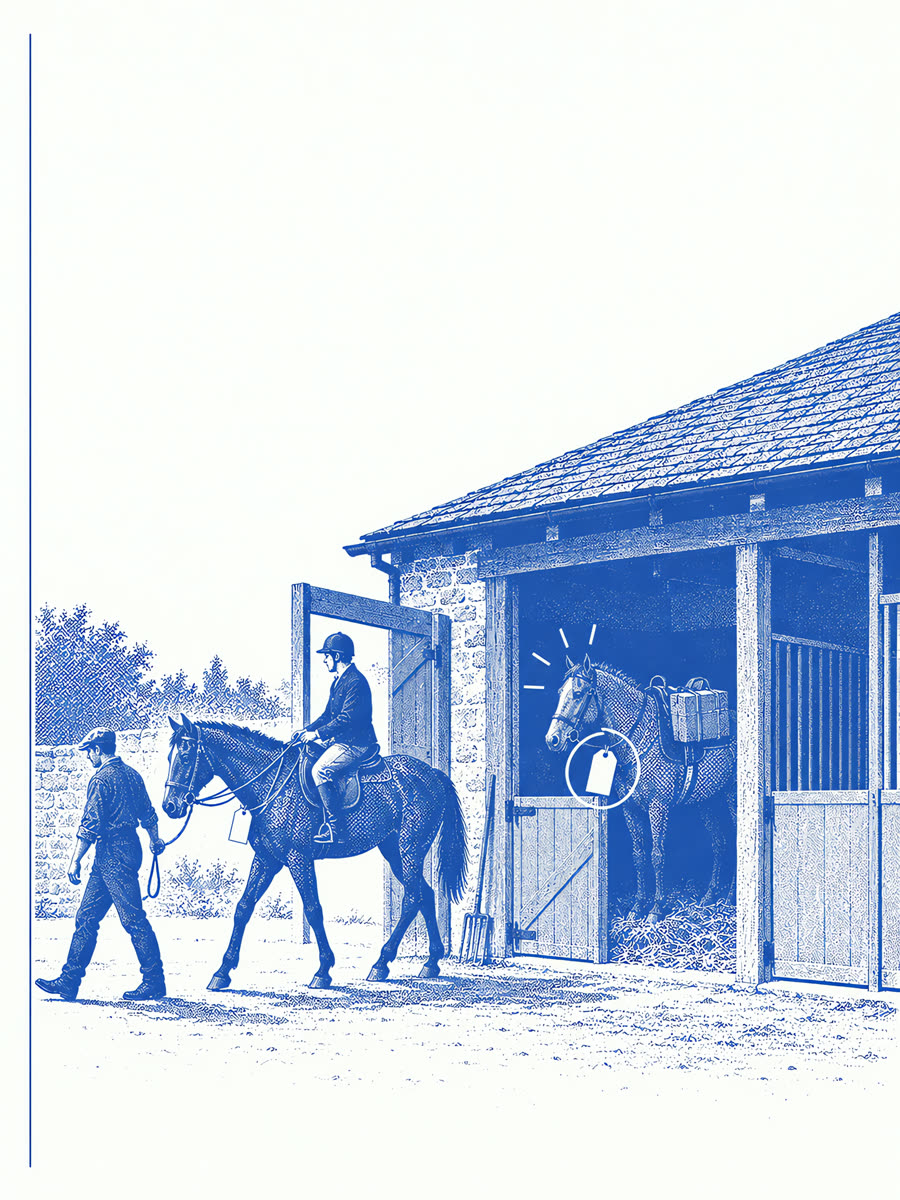
不要骑在一匹正被牵走的马上
每个提供者上岗时,会领一个永不复用的编号。系统认编号不认内容:编号变了,就是换了人,哪怕两位给的东西一模一样 p.63。
为什么这么较真?因为「长得一样」不等于「是同一个」。旧连接可能正在关闭,还握着旧的缓存。依赖它的人如果不重新接,就像骑在一匹正被牵走的马上。
同一个名字,指向不同的东西
清单上写的是名字,比如「数据库」。论文给这个名字留了两个很实用的口子。
隔离:同一个名字,在不同的子环境里各指向一份私有的东西。两个租户的插件都写着「我要数据库」,各自拿到的是自己那一份,看不见对方的。多租户、测试环境、多个 agent 并排跑,都靠它分开。
拦截:在「读依赖」这个动作外面叠一层规则,比如限流、审计、换个实现。提供方和使用方的代码都不用改,改规则也不用重启。
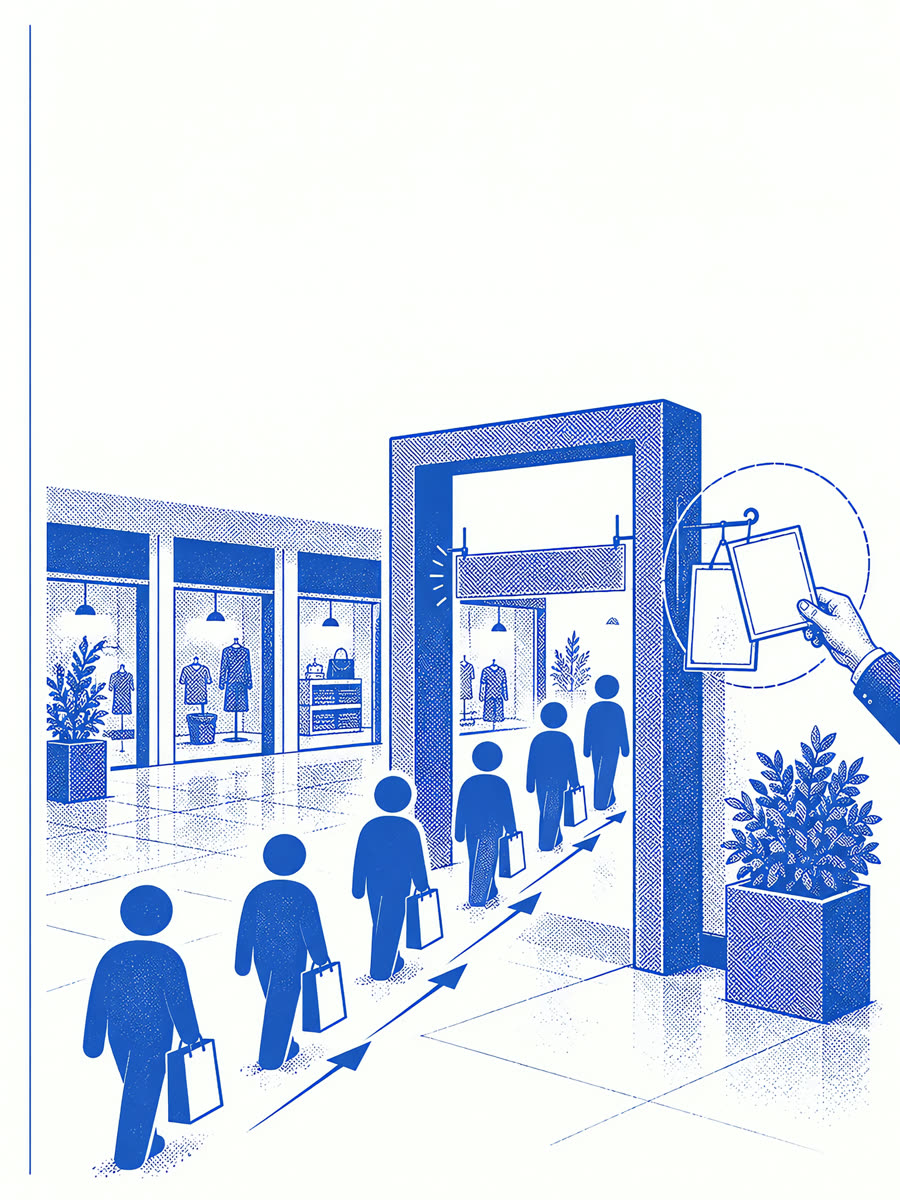
规则加在路上,不加在人身上
拦截像商场门口的安检:进出的人不用改变任何习惯,规则只加在必经之路上。今天要限流,明天要记日志,都是换一道闸的事。
依赖不写死,写成清单:缺了就歇着,齐了就上岗,换了人就重新接。
请改造这个项目里模块之间的依赖关系:
1. 每个模块在开头声明它依赖哪些服务(名字列表),不要在代码中途去「查一下在不在」;
2. 由一个统一的加载器负责:依赖齐全才启动模块;依赖消失就停止模块,并执行它的全部清理;
3. 依赖的提供者被替换时(即使配置相同),依赖它的模块要重新启动;
4. 列出原来那些「检查是否存在 / 失败重试」的代码,说明改造后哪些可以删掉。